Objectif du cours
Un programme manipule des nombres, des caractères, des tableaux, des images, des fichiers et des objets.
Pour comprendre la programmation système, il faut relier :
- l’information logique manipulée par le programme
- sa représentation en mémoire
- son organisation dans une structure
- sa position dans un tableau ou un fichier
- la manière dont le système retrouve cette information
- sont contexte
L’objectif n’est pas de manipuler directement la mémoire en Java, mais de comprendre les mécanismes qui se trouvent derrière les tableaux, les objets, les fichiers, les buffers et les formats binaires.
Une donnée en mémoire
Une variable peut être décrite par plusieurs propriétés :
| Propriété | Signification |
|---|---|
| Valeur | Information stockée, par exemple 25 |
| Type | Interprétation de la valeur |
| Taille | Nombre d’octets utilisés |
| Adresse | Position de début en mémoire |
| Représentation | Suite de bits ou d’octets utilisée par la machine |
On considère :
int temperature = 25;
Du point de vue du programme, temperature contient la valeur 25.
Du point de vue de la machine, cette valeur est codée sous la forme d’une suite d’octets stockée dans une zone mémoire.
La valeur, l’adresse et la taille sont des notions différentes.
Si une donnée commence à l’adresse 1000 et occupe 4 octets, elle utilise les positions suivantes :
Adresse :  1000   1001   1002   1003
           +------+------+------+------+
Donnée  :  |      |      |      |      |
           +------+------+------+------+
L’adresse 1000 désigne le début de la donnée. La taille de la donnée est de 4 octets.
L’adresse
On peut représenter la mémoire comme un tableau de cases numérotées.
Une donnée de plusieurs octets possède généralement une adresse de début.
Par exemple, une donnée de 8 octets commençant à l’adresse 2048 utilise les adresses suivantes :
2048, 2049, 2050, 2051, 2052, 2053, 2054, 2055
L’adresse suivante disponible est 2056.
Dans Java, le programmeur ne manipule pas directement les adresses physiques. La machine virtuelle Java peut déplacer les objets en mémoire, notamment pour permettre au ramasse-miettes de fonctionner. Le programme manipule donc des valeurs et des références, sans supposer une adresse fixe.
Adresse absolue et offset
Une adresse absolue donne une position dans un espace donné :
Adresse : 2048
Un offset donne une distance par rapport à une origine :
Offset : 12 octets depuis le début
Si une structure commence à l’adresse 1000 et qu’un champ se trouve à l’offset 12, son adresse théorique est :
\[ 1000 + 12 = 1012 \]
L’offset est utile pour :
- accéder à un élément de tableau ;
- localiser un champ dans une structure ;
- trouver une information dans un fichier ;
- retrouver un bloc de données ;
- décoder un paquet réseau.
Les pointeurs
Dans un langage comme le C, un pointeur est une variable qui contient une adresse.
int valeur = 25;
int *p = &valeur;
On peut représenter cette situation ainsi :
valeurcontient25&valeurreprésente l’adresse devaleurpcontient cette adresse*ppermet d’accéder à la valeur située à cette adresse.- L’opérateur
&signifie « adresse de ». - L’opérateur
*permet de suivre un pointeur pour accéder à la donnée désignée.
En Java, le programmeur ne dispose pas de ce mécanisme général. Une variable d’objet contient une référence :
Personne p1 = new Personne();
La référence p1 permet d’accéder à l’objet, mais Java n’autorise pas une arithmétique générale sur les adresses.
Références et objets en Java
Considérons :
Personne p1 = new Personne();
Personne p2 = p1;
Un seul objet est créé. Les deux variables désignent cet objet.
Ainsi :
p2.age = 30;
System.out.println(p1.age);
affiche 30, car p1 et p2 font référence au même objet.
Il faut distinguer :
- la variable
p1; - la référence contenue dans
p1; - l’objet créé par
new Personne(); - l’adresse réelle de cet objet, gérée par la JVM.
Une référence Java ressemble conceptuellement à un pointeur, mais elle est plus abstraite et plus contrôlée.
Les tableaux
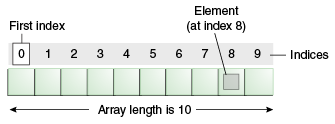
Un tableau regroupe plusieurs éléments de même type.
int[] tab = {10, 20, 30, 40};
Les indices commencent à zéro :
Indice :     0      1      2      3
Valeur :    10     20     30     40
Dans un modèle simplifié où un entier occupe 4 octets et où le tableau commence à l’adresse 1000 :
Élément       Adresse
tab[0]          1000
La formule est :
$$ \text{adresse}(tab[i]) = \text{adresse}(tab) +i \times \text{taille d'un élément}$$
L’offset de tab[i] est donc :
$$ \text{offset}(i) = i \times \text{taille d'un élément}$$
Pour tab [] :
$$\text{offset}(3) = 3 \times 4 = 12$$
Si le tableau commence à 1000 :
$$\text{adresse}(tab) = 1000 + 12 = 1012$$
Cette organisation permet un accès direct à un élément. Il n’est pas nécessaire de lire tous les éléments précédents.
Les tableaux multidimensionnels
Une image peut être représentée par une matrice :
int[][] image = new int [3][4];
Elle contient trois lignes et quatre colonnes.
Dans une représentation linéaire par lignes, l’offset de image[i][j] est :
$$ \text{offset}(i,j)=(i \times \text{nombre de colonnes} + j) \times \text{taille d'un élément}\] Pour une matrice de 4 colonnes et des éléments de 4 octets : $$ \text{offset}(2,3) = (2 \times 4 + 3) \times 4 = 44$$
En Java, un tableau à deux dimensions est un tableau de références vers des tableaux. Les lignes peuvent donc être considérées comme des objets distincts. Les tableaux Java sont des objets indexés dont les composants sont accessibles de 0 à n - 1. docs.oracle
Les structures
Une structure regroupe plusieurs informations qui décrivent un même objet.
En Java :
class Pixel {
    int rouge;
    int vert;
    int bleu;
}
Un objet Pixel contient trois champs :
Cette structure peut représenter :
- un pixel ;
- une personne ;
- une entrée de fichier ;
- un processus ;
- un paquet réseau ;
- une mesure ;
- une commande.
Une structure répond à la question suivante :
Quelles informations doivent être regroupées pour représenter une même entité ?
Exemple :
class EnteteFichier {
    int version;
    int taille;
    int type;
}
L’entête associe plusieurs champs qui doivent être lus et interprétés ensemble.
Alignement et remplissage
La taille logique d’une structure n’est pas toujours égale à la somme exacte de la taille de ses champs.
On considère :
struct Exemple {
    char c;
    int i;
}
Avec les hypothèses suivantes :
charoccupe 1 octet ;intoccupe 4 octets ;intdoit commencer à une adresse multiple de 4.
La mémoire peut être organisée ainsi :
Offset       0      1      2      3      4      5      6      7
             +------+------+------+------+------+------+------+------+
Contenu      |  c   | pad  | pad  | pad  |      int i             |
             +------+------+------+------+------+------+------+------+
Les trois octets pad sont des octets de remplissage.
Ils n’appartiennent à aucun champ logique, mais ils permettent de respecter l’alignement demandé par la machine.
L’ordre des champs peut donc modifier la taille totale.
En Java, la disposition exacte des champs dans un objet est généralement gérée par la JVM. Il ne faut donc pas supposer qu’une classe Java possède une représentation mémoire identique à une structure C.
Structure et union
Dans une structure, chaque champ possède une zone distincte.
struct Valeur {
    int entier;
    float reel;
}
Les deux champs peuvent exister simultanément.
Dans une union, plusieurs champs partagent la même zone mémoire.
union Valeur {
    int entier;
    float reel;
}
La taille de l’union doit être suffisante pour contenir son membre le plus volumineux.
Une union est adaptée lorsqu’une donnée peut prendre plusieurs formes, mais une seule forme à la fois.
Pour savoir quelle interprétation utiliser, on associe généralement une étiquette :
Java ne fournit pas directement une union mémoire classique. On utilise plutôt :
- une classe contenant plusieurs champs ;
- une hiérarchie de classes ;
- une énumération indiquant le type actif ;
- une classe abstraite ;
- une classe scellée ;
- un type générique.
Les fichiers comme suites d’octets
Un fichier est une suite d’octets enregistrée sur un support.
Pour comprendre ces octets, il faut connaître leur format.
Un format de fichier définit généralement :
- une signature ;
- un en-tête ;
- des métadonnées ;
- des données ;
- parfois une somme de contrôle ;
- parfois une structure de blocs.
Sans la description du format, les octets ne possèdent pas de signification exploitable.
Par exemple, la suite suivante :
01 00 FF 28 7A ...
peut correspondre à :
- un nombre ;
- une couleur ;
- une instruction ;
- une partie d’image ;
- un en-tête ;
- des données compressées.
La signification dépend du format utilisé.
Le magic number
Un magic number, ou nombre magique, est une valeur ou une suite d’octets placée à une position connue, souvent au début d’un fichier.
Cette valeur sert à identifier ou à vérifier le format.
La commande Unix file utilise notamment le contenu initial d’un fichier pour déterminer son type, et non pas uniquement son extension. docs.oracle
L’extension :
image.png
est seulement une convention de nommage.
Le contenu réel du fichier peut commencer par une signature propre au format PNG.
Un magic number permet notamment de :
- vérifier qu’un fichier correspond à son extension ;
- sélectionner le bon parseur ;
- détecter un fichier incorrect ;
- rejeter rapidement un format inconnu ;
- différencier plusieurs formats binaires.
Exemple avec le format PPM
Un fichier PPM au format texte peut commencer par :
P3
Exemple :
P3
# Image simple
2 1
255
255 0 0
0 255 0
Le début du fichier contient :
Le programme doit généralement :
- vérifier la signature
P3; - lire la largeur ;
- lire la hauteur ;
- lire la valeur maximale ;
- lire les composantes des pixels ;
- vérifier que les valeurs sont valides.
Exemple de lecture conceptuelle en Java :
String magic = scanner.next();

if (!magic.equals("P3")) {
    throw new IOException("Format PPM incorrect");
}

int largeur = scanner.nextInt();
int hauteur = scanner.nextInt();
int valeurMaximale = scanner.nextInt();
Dans l’examen précédent, cette logique est utilisée pour lire une image PPM et construire une structure Java de type int[][][].
Offset dans un fichier
Un offset de fichier est une position relative au début du fichier.
Considérons ce format fictif :
Offset  Taille  Contenu
0       4       Signature "DATA"
4       2       Version
6       4       Taille des données
10      1       Type
11      ...     Données
L’offset indique une position relative :
- la signature commence à l’offset
0; - la version commence à l’offset
4; - la taille commence à l’offset
6; - les données commencent à l’offset
11.
Il faut distinguer :
| Notion | Exemple | Signification |
|---|---|---|
| Adresse | 0x7FFD... |
Position dans la mémoire |
| Offset | 11 |
Distance depuis une origine |
| Indice | i = 3 |
Position logique dans un tableau |
| Numéro de bloc | bloc 42 |
Identifiant d’un bloc de stockage |
Lien avec la programmation système
Ces notions sont utilisées dans de nombreux domaines.
Tableaux
L’indice est transformé en offset pour retrouver un élément.
int[] valeurs = new int[100];
int element = valeurs[12];
Le système doit associer l’indice 12 à une position dans le tableau.
Images
Les coordonnées d’un pixel sont transformées en offset dans une séquence de pixels.
int largeur = 640;
int x = 20;
int y = 10;
int canal = 2;

int offset = ((y * largeur + x) * 3) + canal;
Ici, canal vaut 0 pour le rouge, 1 pour le vert et 2 pour le bleu.
Fichiers
Les offsets permettent d’atteindre rapidement un champ dans un en-tête ou une table.
RandomAccessFile fichier = new RandomAccessFile("donnees.bin", "r");

fichier.seek(11);
int premierOctet = fichier.readUnsignedByte();
La méthode seek positionne la lecture à un offset donné dans le fichier.
Réseau
Les paquets sont composés de champs placés à des positions définies par un protocole.
byte version = paquet[0];
byte type = paquet [1];
int longueur = ((paquet [2] & 0xFF) << 8) | (paquet [3) & 0xFF);
Le programme interprète chaque octet selon la position définie par le protocole.
Systèmes de fichiers
Les blocs et les pointeurs permettent de retrouver les données d’un fichier.
Processus
Un processus possède notamment des zones de mémoire, une pile, un tas, du code et des données.
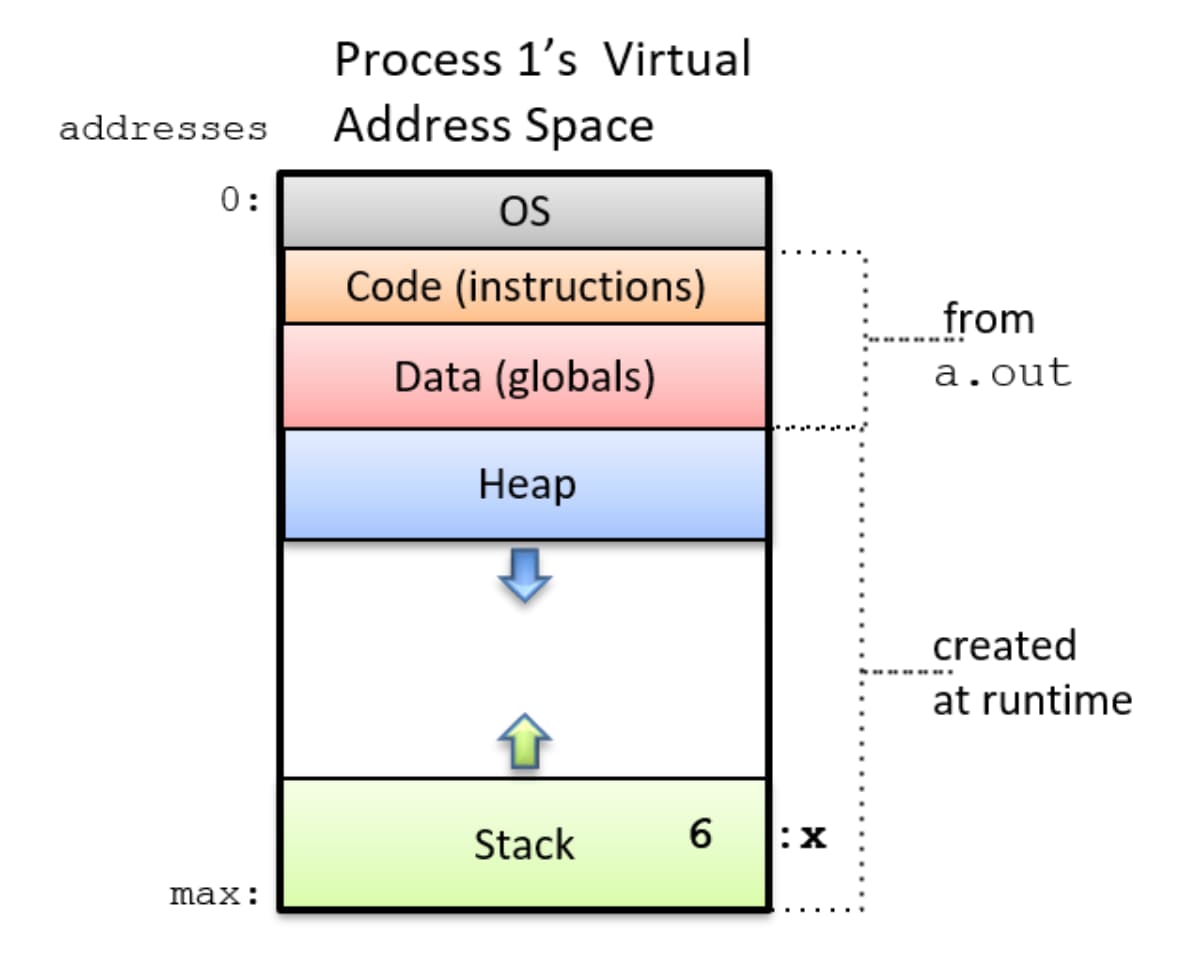
La mémoire d’un processus est organisée en zones ayant des rôles différents. Le code contient les instructions, les données globales contiennent certaines variables, le tas est utilisé pour les allocations dynamiques et la pile contient notamment les appels de fonctions et les variables locales.
À retenir
- Une donnée possède une valeur, un type, une taille et une représentation.
- Une adresse indique une position mémoire.
- Un offset indique une distance par rapport à une origine.
- Un pointeur contient une adresse dans les langages bas niveau.
- Une référence Java désigne un objet sans permettre une arithmétique directe sur les adresses.
- Un tableau permet de retrouver un élément grâce à son indice et à la taille de ses éléments.
- Une structure regroupe plusieurs champs.
- Une union superpose plusieurs interprétations sur une même zone.
- L’alignement peut ajouter des octets de remplissage.
- Un fichier possède généralement une structure interne.
- Un magic number permet d’identifier ou de valider un format.
- Les mêmes notions se retrouvent dans les tableaux, les images, les fichiers, les paquets réseau et les systèmes de fichiers.